Claude Sonnet 4.6のVision、画像サイズの上限は1568pxだけじゃなかった
この記事は、構成と文章の整理にAIを使っています。
あくまで読みやすくするための補助で、内容そのものをAIにすべて任せて書いているわけではありませんが、ところどころ相談しながら整えています。
この内容は2026年8月時点のStandard tier(Sonnet 4.6以前)の情報。今後のモデルで数値やtier分けが変わる可能性はある。
結論
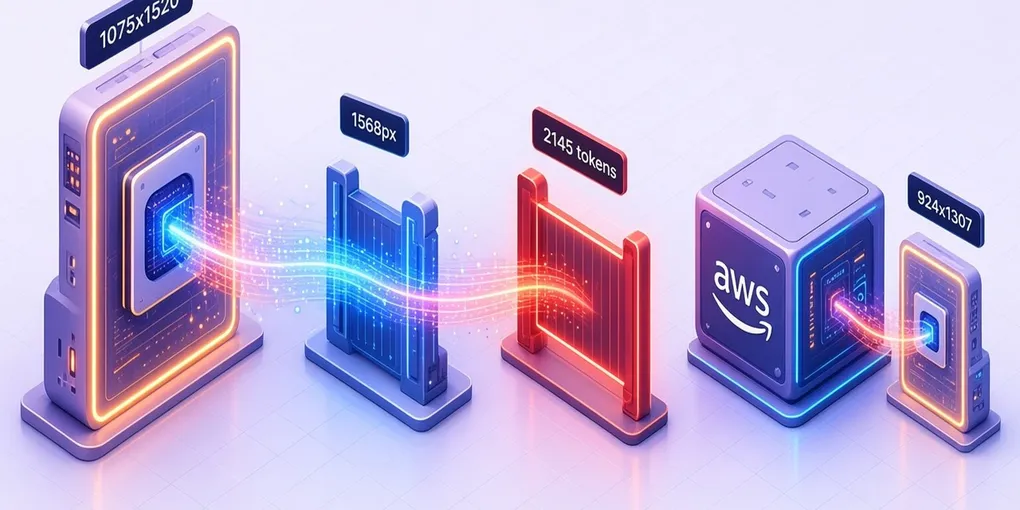
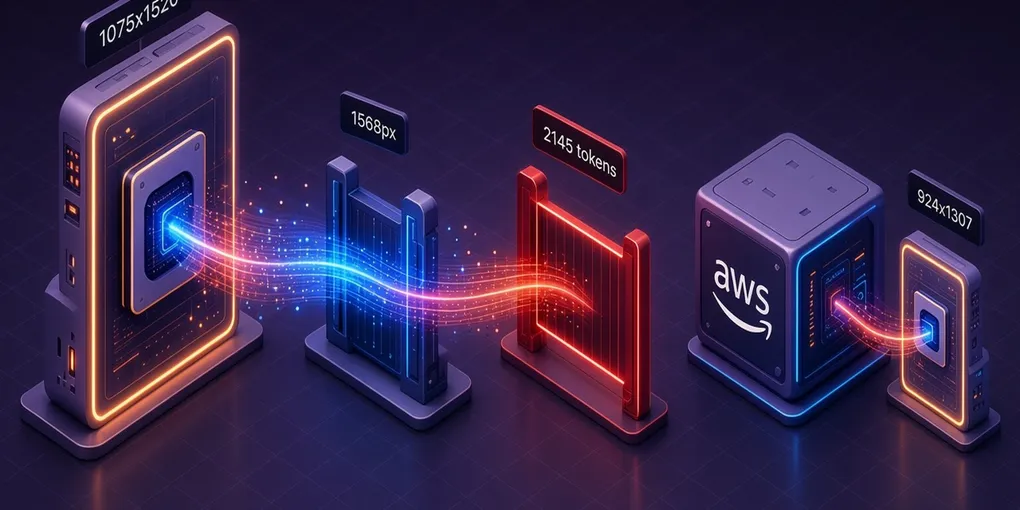
Claude(Sonnet 4.6)にVisionで画像を投げる場合、上限は「長辺1568px」だけじゃない。長辺1568px と visual token 1568トークン(⌈幅/28⌉ × ⌈高さ/28⌉)の2つの上限があって、どっちか先に超えた方で自動的に縮小される。しかも縦長・ポートレート形状の画像は、長辺が1568px以内でもtokenの方で先に引っかかることがある。
モデルごとのtier
Sonnet 4.6はStandard tier。Claude 4.7以降はHigh-resolution tierになる。
| tier | 対象モデル | 長辺上限 | tokenの上限 |
|---|---|---|---|
| Standard | 4.6以前(Sonnet 4.6含む) | 1568px | 1568 |
| High-resolution | Claude 4.7以降 | 2576px | 4784 |
High-resolution tierは主にcomputer use・スクリーンショット理解・密なドキュメント向けらしい。必要ないなら事前にダウンサンプルした方がいい。
自動縮小: 長辺 or token、どっちか先に引っかかる
縮小はアスペクト比を保ったまま、両方の上限に収まる最大サイズまで行われる。ここでハマりやすいのが縦長画像。
例: A4を130DPIでスキャンすると1075×1520pxになる。
- 長辺1520px → 1568px以内なのでセーフに見える
- でもtoken数を計算すると
⌈1075/28⌉ × ⌈1520/28⌉ = 39 × 55 = 2145 token - Standard tierのtoken上限(1568)を超えている → 結局縮小される
- 縮小後: 924×1307px
「長辺が上限以内だから大丈夫」で判断すると、縦長画像で普通に踏み抜く。名刺のような縦長画像は注意した方がいい。
縮小後にパディングも入る
縮小されたかどうかに関わらず、画像は下端・右端が28pxの倍数になるまでパディングされる(例: 924×1307 → 924×1316)。パディング部分は中身が空。座標系のタスク(bounding boxとか)を扱わないなら、あまり気にしなくていい。
ハードリミット(縮小じゃなくてリジェクトされる方)
自動縮小とは別に、超えたらそもそもリクエストが400エラーで弾かれる上限がある。
- 長辺: 8000×8000px
- ファイルサイズ(base64後): 直APIは10MB、Bedrock/Google Cloudは5MB
こっちはSDKもAPIも縮小してくれない。超えたら普通にエラーになるだけなので、事前に自分でリサイズ・圧縮するしかない。
複数画像を1リクエストに入れる場合
上限は画像1枚ごとに個別判定される。tokenも画像ごとに計算されて単純合算される。「複数枚だから割引」みたいな仕組みはない。
注意点が1つある。1リクエストに21枚以上の画像(Bedrock/Google CloudではPDFなどのdocumentブロックも含む)を入れると、1枚あたりの寸法上限がさらに厳しくなって2000pxになる。超えるとinvalid_request_errorで“many-image requests”系のエラーが返る。
- 20枚以内: 各画像は8000pxまでOK(ただしtoken消費を考えると1568px基準でリサイズしといた方がいい)
- 21枚以上: 各画像を2000px以内にリサイズしないと弾かれる
リサイズはSDKじゃなくてAPI/サーバー側でやっている
これも整理しておく。Python SDKやboto3などのクライアント側ライブラリは画像のリサイズを一切やらない。base64エンコードしてHTTPで送るだけ。ここまで書いた「1568px/1568トークンへの自動縮小」は、Anthropic側の推論パイプラインで行われる処理で、クライアントは関与しない。
事前にリサイズしておく意味は「精度を上げるため」じゃなくて、「無駄なペイロード転送とレイテンシを削るため」。自動縮小後の結果は事前リサイズしても変わらないので、精度そのものは変わらない。
リサイズと圧縮は別物
ここ、最初混同してた。「なるべく軽くする」って一括りにすると危ない。
- リサイズ = 解像度(px)を変えること。1568px基準まで縮めるのは基本的に問題ない。どうせサーバー側で同じサイズに丸められるので、精度への影響はゼロ
- 圧縮 = JPEG qualityでファイルサイズを削ること。こっちは潰れるので慎重にやる必要がある
なので「なるべく圧縮」は正確には「なるべくリサイズ」と言うべきで、リサイズは積極的にやっていい。圧縮(quality)の方はそこまで攻めなくていい。
圧縮のかけすぎには注意
JPEG qualityを落としすぎると、逆に精度が落ちるケースがあるらしい。特に画像内の文字が小さい場合、圧縮アーティファクトで読みにくくなることが公式ドキュメントでも触れられていた。目安としてはquality 85〜90くらいまでは基本セーフ(体感、要検証)。ファイルサイズよりテキストの可読性を優先した方が良さそう。実機で試して確認したわけではないので、そこは未確認。
本当に効くのはクロップ
リサイズ・圧縮より前に効くのがクロップ。名刺全体が写った画像をそのまま1568pxに縮めると、電話番号やメールアドレスの文字自体が相対的に小さくなって、JPEG qualityを100にしてても構成ピクセル数が足りず読めなくなる。
優先順位はこう。
- 連絡先など、文字が写ってる領域だけ先に切り出す
- 切り出した領域を1568px基準にリサイズ
- JPEG qualityは85〜90くらいで確保、無理に絞らない
ハイブリッドOCR + Bedrockの構成なら、OCR側で先に文字領域を検出してクロップしてからBedrockに渡す設計が理にかなってる。
事前リサイズで得するのは通信量とレイテンシーだけ
サーバーに送る前にギリギリまで小さくしておくと、
- base64エンコード後のペイロードサイズが減る → 通信量削減
- サーバー側の「受信→自動縮小→処理」というステップの一部を省ける → レイテンシー短縮
精度はどうせ自動縮小後と同じ結果になるので変わらない。得するのは通信とレイテンシーだけ、というのが結論。